Un visiteur qui trouve immédiatement ce qu'il cherche — ou quelque chose qu'il n'attendait pas mais qui correspond précisément à son besoin — convertit mieux et revient plus souvent. Les moteurs de recommandation permettent ce résultat à grande échelle, quelle que soit la taille du catalogue. Cet article détaille les familles d'algorithmes disponibles, l'architecture technique à retenir et les étapes concrètes d'intégration pour un site e-commerce moderne.
Pourquoi les recommandations produits modifient vos résultats
Les recommandations produits agissent sur deux leviers simultanément : la pertinence de l'offre affichée et le moment où elle apparaît dans le parcours. Un produit complémentaire proposé au bon moment augmente le panier moyen. Un article similaire affiché sur une page de rupture de stock réduit les sorties du tunnel de conversion.
Ces effets sont mesurables. Sur une refonte headless intégrant un moteur de recommandation IA, Groupe Atlas a enregistré +38 % sur le panier moyen. Ce type de résultat est documenté lorsque les recommandations sont connectées aux données comportementales en temps réel, et non générées à partir de règles statiques fixées manuellement.
Le levier n'est pas réservé aux grandes plateformes. Toute boutique disposant d'un catalogue actif peut bénéficier d'un moteur correctement configuré, à condition de disposer d'un minimum d'historique de navigation ou d'achat pour initialiser les modèles.
Les trois familles d'algorithmes à maîtriser
Il existe trois approches principales, chacune adaptée à une situation différente.
| Famille | Principe | Cas d'usage privilégié |
|---|---|---|
| Filtrage collaboratif | Recommande ce que des utilisateurs aux comportements similaires ont consulté ou acheté | Catalogue large, historique d'achat suffisant |
| Filtrage par contenu | Compare les attributs des produits (catégorie, prix, caractéristiques) pour proposer des articles proches | Utilisateurs nouveaux, catalogue avec métadonnées riches |
| Approche hybride | Combine les deux méthodes pour compenser leurs angles morts respectifs | Sites à trafic mixte (nouveaux visiteurs et récurrents) |
Le filtrage collaboratif souffre du problème du démarrage à froid (cold start) : sans historique suffisant, le moteur ne peut rien proposer de pertinent pour un nouvel utilisateur ou un produit récemment ajouté. Le filtrage par contenu contourne cet obstacle mais produit souvent des recommandations trop proches de ce que l'utilisateur connaît déjà, limitant la découverte du catalogue. L'approche hybride, supportée par des bibliothèques comme TensorFlow Recommenders, combine les deux familles de signaux et s'adapte à mesure que les données grossissent.
Architecture technique d'un moteur de recommandation
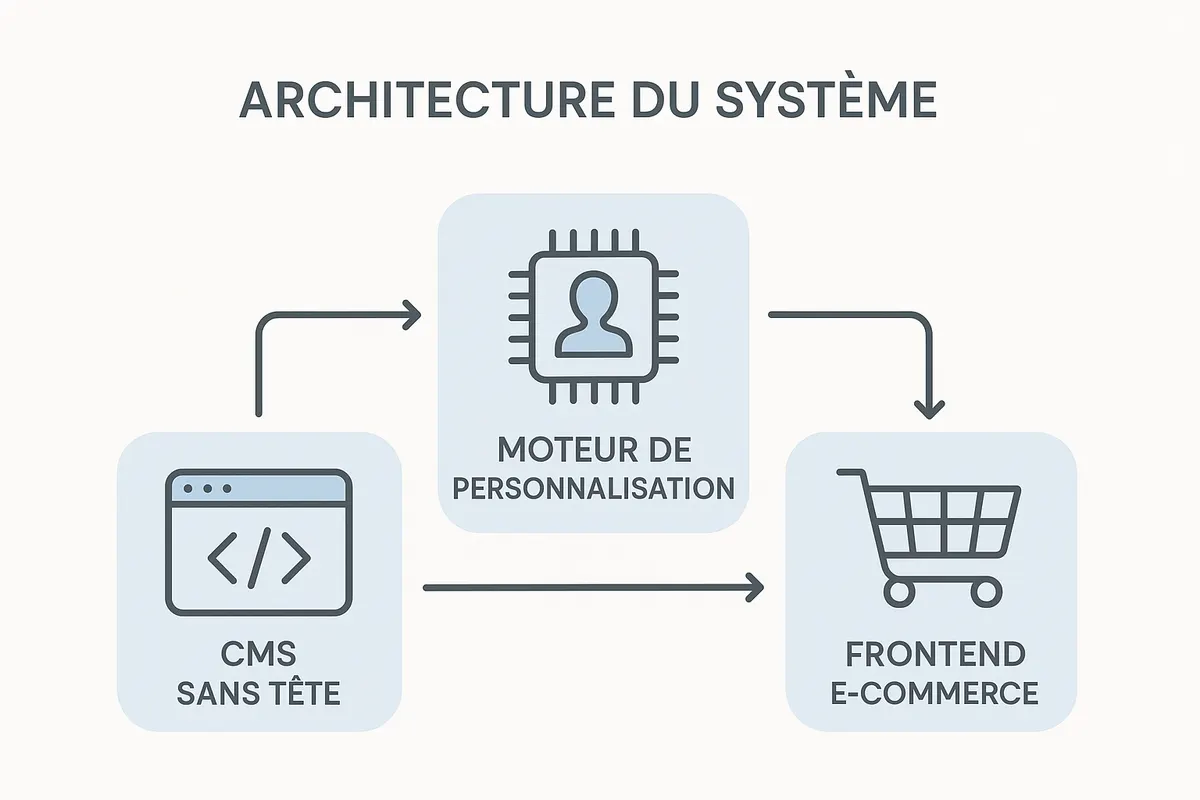
Un moteur performant repose sur quatre couches qu'il faut concevoir indépendamment pour pouvoir les faire évoluer sans tout reconstruire.
Couche de collecte. Les événements utilisateurs — vues de produits, ajouts au panier, achats, durée de consultation — sont capturés via des appels API légers déclenchés côté client. Ces données alimentent un entrepôt ou un data lake où elles sont normalisées et horodatées avant tout traitement.
Couche de traitement et scoring. Un pipeline calcule périodiquement — ou en temps réel selon la charge — les scores de pertinence entre utilisateurs et produits. Les modèles à deux tours (two-tower neural networks) excellent pour capter des relations non linéaires dans des catalogues de plusieurs milliers de références.
Couche API. Le moteur expose un endpoint REST ou GraphQL qui reçoit un identifiant utilisateur ou une session anonyme et retourne une liste ordonnée de références avec leurs scores. La latence cible est sous 100 ms pour préserver les indicateurs de performance — un point central dans le guide d'audit technique e-commerce.
Couche front-end. Le frontend consomme l'API et rend les produits recommandés. Sur une architecture headless découplée, cette couche est indépendante du moteur : vous pouvez changer d'algorithme ou de fournisseur sans toucher au template de rendu.
Intégration côté front : appel API et mise en cache
Voici un exemple d'appel minimal en JavaScript :
fetch('/api/recommendations?userId=123&context=product-page&limit=6')
  .then(res => res.json())
  .then(({ items }) => renderRecommendations(items))
  .catch(() => { /* dégradation silencieuse */ });
Quelques décisions à prendre dès la conception :
- Visiteurs anonymes : générez des recommandations populaires ou basées sur la catégorie consultée, précalculées côté serveur. La personnalisation s'active une fois la session identifiée.
- Rendu côté serveur (SSR) : pour les pages produit, préférez un appel serveur afin d'éviter le décalage de contenu visible au chargement initial.
- Dégradation gracieuse : si le moteur est indisponible, affichez les meilleures ventes de la catégorie plutôt qu'un bloc vide.
- Consolidation des requêtes : groupez les appels par page plutôt qu'un appel indépendant par widget.
Sur les projets Next.js, l'Incremental Static Regeneration (ISR) permet de précalculer les recommandations des produits les plus visités et de revalider le cache toutes les heures, ce qui réduit la charge sur le moteur sans sacrifier la fraîcheur des données.
Mesurer l'efficacité de vos recommandations
Trois indicateurs sont prioritaires pour évaluer un moteur en production.
- Taux de clics (CTR) : proportion de sessions où un produit recommandé a été cliqué. Un CTR faible signale un problème de pertinence ou de placement sur la page.
- Valeur moyenne du panier (AOV) : comparez l'AOV des sessions ayant interagi avec les recommandations par rapport aux autres. C'est le principal indicateur de valeur métier.
- Taux de conversion sur les pages de rupture : mesurez si les recommandations réduisent les sorties sans achat lorsqu'un produit est indisponible.
Ces métriques ne s'évaluent pas à vue d'œil : utilisez des tests A/B structurés pour mesurer l'impact réel de chaque changement d'algorithme ou de placement. Un test mal conçu — groupes déséquilibrés, durée insuffisante, métriques mal définies — peut conclure à un gain inexistant.
Points de vigilance avant le déploiement
Problème du démarrage à froid. Les nouveaux utilisateurs et les produits récemment ajoutés n'ont pas d'historique. Prévoyez une stratégie de repli : recommandations populaires par catégorie, puis personnalisation progressive à mesure que les interactions s'accumulent.
Conformité RGPD. La collecte de données comportementales est soumise au consentement explicite. Le moteur doit fonctionner en mode dégradé — recommandations basées sur la popularité, non personnalisées — pour les visiteurs refusant les cookies de mesure.
Biais de popularité. Sans rééquilibrage, un filtrage collaboratif tend à sur-recommander les produits déjà les plus vendus, appauvrissant la découverte du catalogue. Introduisez une dose d'exploration dans le scoring pour exposer des références moins visibles.
Impact sur les performances. Chaque widget de recommandation représente un appel réseau supplémentaire. Différez le chargement avec IntersectionObserver pour les blocs bas de page, consolidez les requêtes et surveillez l'impact sur vos Core Web Vitals. Pour aller plus loin sur les usages de l'IA appliquée au commerce, l'article 10 cas d'usage IA en e-commerce présente un panorama plus large des leviers disponibles.
Par où commencer
Avant de choisir un outil ou de développer un moteur maison, trois questions permettent d'orienter la décision : votre catalogue dépasse-t-il une centaine de références actives ? Disposez-vous d'au moins quelques semaines d'historique de navigation ? Avez-vous les ressources pour maintenir le pipeline de données dans la durée ?
Si ces conditions sont réunies, une implémentation sur mesure est justifiée et rentable à moyen terme. Dans le cas contraire, un service de recommandation connecté via API à votre CMS headless permet d'obtenir des résultats rapidement avant d'investir dans une architecture propriétaire.
Webntricks accompagne les équipes e-commerce de la phase de sélection algorithmique jusqu'au déploiement et au suivi des indicateurs de performance. Découvrez nos expertises en IA et automatisation ou contactez-nous pour cadrer votre projet de personnalisation.
Questions fréquentes
Quelle est la différence entre les recommandations temps réel et les recommandations statiques ?
Les recommandations temps réel s'ajustent dynamiquement en fonction des comportements récents de l'utilisateur lors de la session en cours. Les recommandations statiques affichent une liste fixe précalculée, généralement basée sur les données agrégées de l'ensemble des utilisateurs. Le temps réel est plus pertinent pour les utilisateurs identifiés avec un historique ; les recommandations statiques conviennent aux visiteurs anonymes ou aux pages nécessitant une faible latence.
Comment gérer le démarrage à froid pour un nouveau produit ou un nouvel utilisateur ?
Sans historique, le moteur ne peut personnaliser les recommandations. La stratégie habituelle consiste à afficher les meilleures ventes de la catégorie pour les nouveaux utilisateurs, et à appliquer le filtrage par contenu pour les nouveaux produits en s'appuyant sur leurs attributs (catégorie, prix, caractéristiques). La personnalisation collaborative s'active progressivement dès que l'historique est suffisant.
Un moteur de recommandation peut-il fonctionner sur un CMS headless ?
Oui, c'est même l'architecture recommandée. Le moteur expose une API indépendante du CMS ; le front-end headless appelle cet endpoint au moment du rendu et affiche les produits retournés. Cette séparation permet de changer d'algorithme ou de fournisseur sans modifier le template de rendu, et de tester différentes variantes via A/B testing.