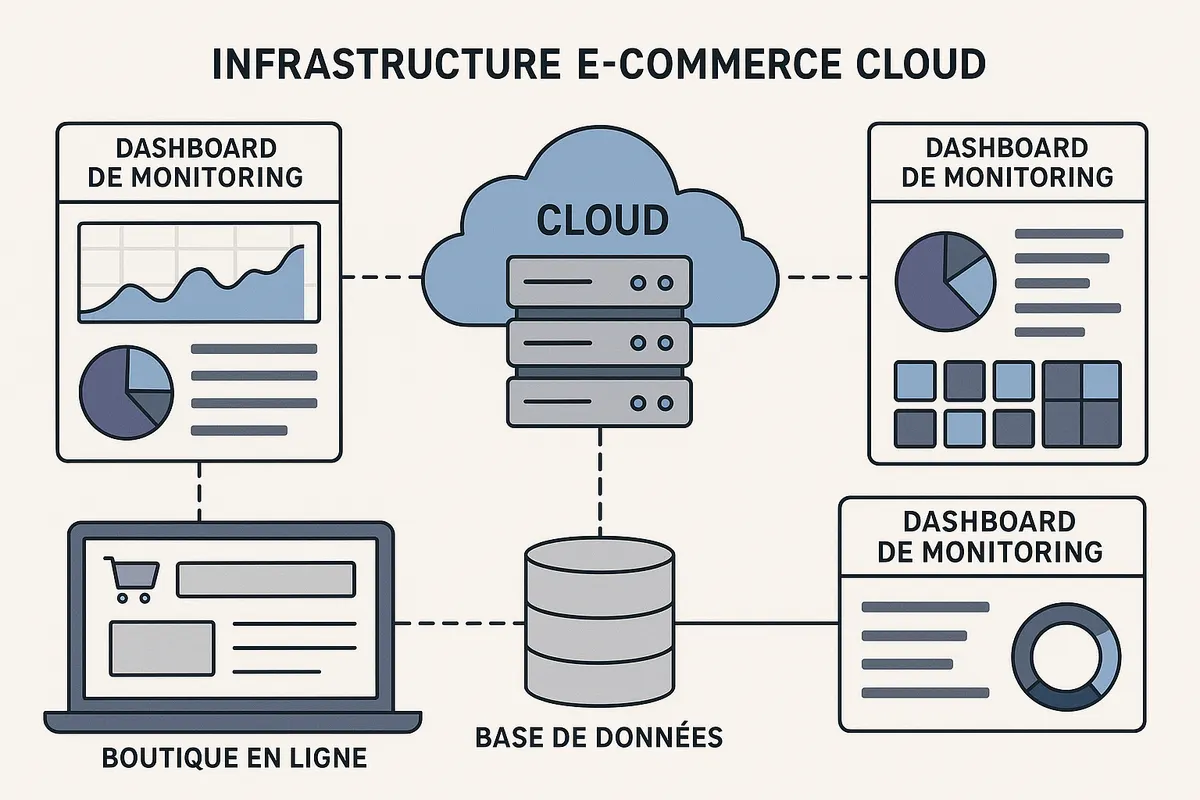
Un pic de trafic non anticipé, une requête SQL qui dérive, un service de paiement qui ne répond plus : sur un e-commerce, chaque anomalie non détectée coûte des commandes et dégrade la confiance des acheteurs. Le monitoring DevOps est la discipline qui transforme votre infrastructure en un système observable, capable d'alerter avant que vos clients ne signalent le problème.
Cet article présente les piliers d'un monitoring appliqué au contexte e-commerce, les outils qui composent une stack mature, et les erreurs d'intégration rencontrées le plus souvent en production.
Les trois signaux fondamentaux de l'observabilité
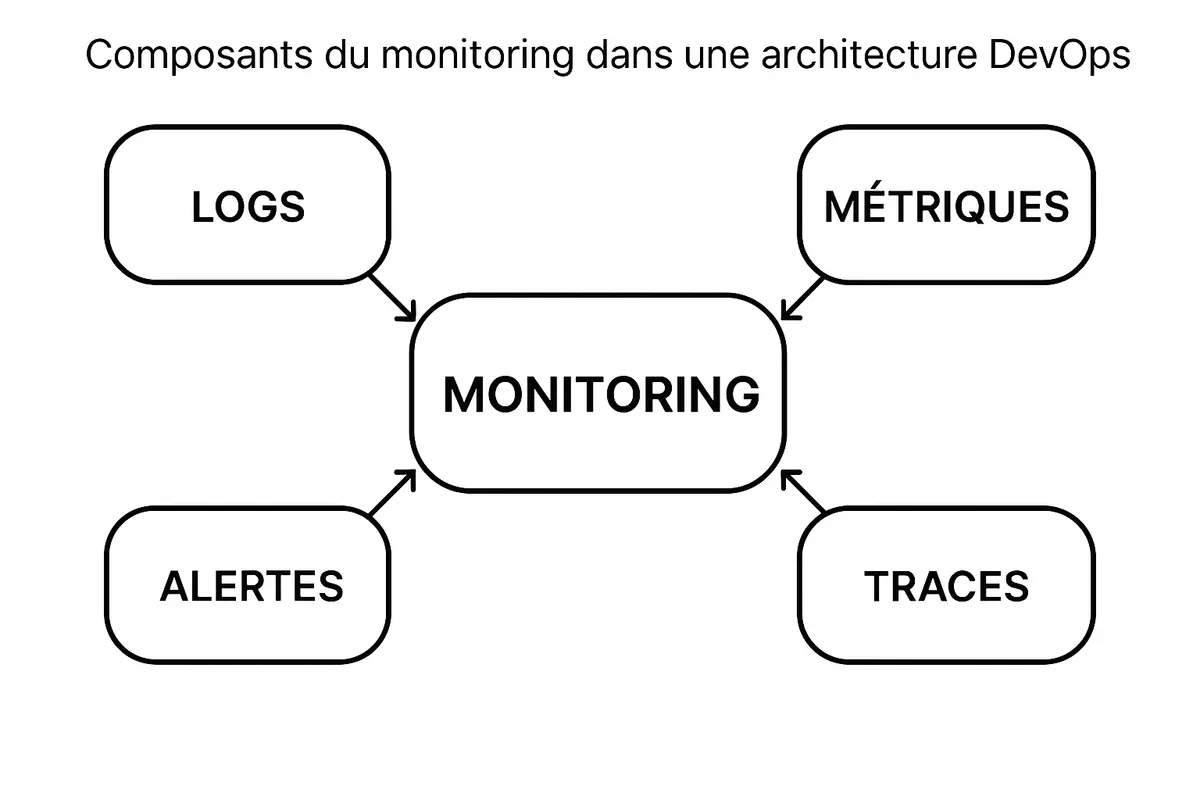
Le monitoring d'une infrastructure e-commerce repose sur trois types de données complémentaires, popularisés par le standard OpenTelemetry (framework ouvert porté par la Cloud Native Computing Foundation) :
- Métriques : mesures numériques horodatées — temps de réponse, taux d'erreur HTTP, saturation CPU. Elles permettent de détecter une tendance et de déclencher des alertes sur seuil.
- Logs : enregistrements structurés émis par chaque composant. Ils fournissent le contexte détaillé d'une erreur ou d'un comportement inattendu.
- Traces distribuées : chemin complet d'une requête à travers l'ensemble des services appelés. Indispensables pour localiser le goulet d'étranglement dans une architecture microservices ou headless.
Ces trois signaux sont complémentaires : une alerte sur une métrique indique qu'un problème existe, les traces montrent où il se produit, et les logs expliquent pourquoi. Travailler avec un seul de ces signaux revient à diagnostiquer une panne avec la moitié des instruments.
Les outils d'une stack de monitoring e-commerce
La composition de votre stack dépend de votre architecture, de la taille de l'équipe et du budget opérationnel. Voici les briques les plus répandues en production.
Prometheus — collecte de métriques
Prometheus collecte les métriques en interrogeant les endpoints exposés par vos applications et vos nœuds d'infrastructure. Son modèle de données en séries temporelles et sa compatibilité native avec Kubernetes en font la référence pour les environnements conteneurisés. Il s'associe à un Alertmanager pour router les notifications vers PagerDuty, Slack ou votre canal d'astreinte.
Grafana — visualisation
Grafana se connecte à Prometheus, Loki et une trentaine d'autres sources pour produire des dashboards opérationnels. Un dashboard e-commerce type regroupe : latence du tunnel de paiement par étape, taux d'erreur par endpoint API, profondeur de file d'attente des commandes asynchrones, et saturation des ressources base de données.
Loki — centralisation des logs
Loki (Grafana Labs) indexe les métadonnées des logs plutôt que leur contenu complet, ce qui réduit le coût de stockage par rapport à Elasticsearch. Il s'intègre nativement avec Grafana pour corréler les logs avec les métriques au moment d'un incident.
Datadog — solution SaaS unifiée
Datadog regroupe métriques, logs, traces et monitoring synthétique dans une plateforme managée. Elle convient aux équipes qui souhaitent réduire la charge opérationnelle sur l'infrastructure de monitoring elle-même, au prix d'un abonnement mensuel à calibrer selon le volume ingéré.
Les métriques e-commerce à surveiller en priorité
Au-delà des métriques d'infrastructure, plusieurs indicateurs liés à l'expérience d'achat méritent une instrumentation dédiée :
- Temps de réponse du tunnel de commande : chaque seconde de latence supplémentaire sur la page panier ou la page de paiement a un impact direct sur le taux de complétion. Instrumentez chaque étape séparément pour isoler les ralentissements.
- Taux d'erreur des appels API de paiement : un taux d'erreur même modeste sur Stripe, Mollie ou PayPal entraîne des pertes de commandes souvent silencieuses — le client abandonne sans message d'erreur visible.
- Latence des jobs asynchrones : traitement des commandes, mise à jour des stocks, envoi de confirmations. Un retard croissant sur ces files d'attente signale une saturation à traiter avant qu'elle ne dépasse votre SLA client.
- Core Web Vitals : LCP (Largest Contentful Paint) et CLS (Cumulative Layout Shift) mesurent la qualité perçue de la navigation. Leur dégradation impacte à la fois l'expérience utilisateur et le référencement naturel.
Intégrer le monitoring dès le déploiement
Le piège classique consiste à traiter le monitoring comme une tâche post-lancement. Une instrumentation ajoutée a posteriori est incomplète : elle manque les événements internes les plus précieux et force des modifications de code dans un contexte de production déjà sous tension.
Quatre pratiques permettent d'éviter cet écueil :
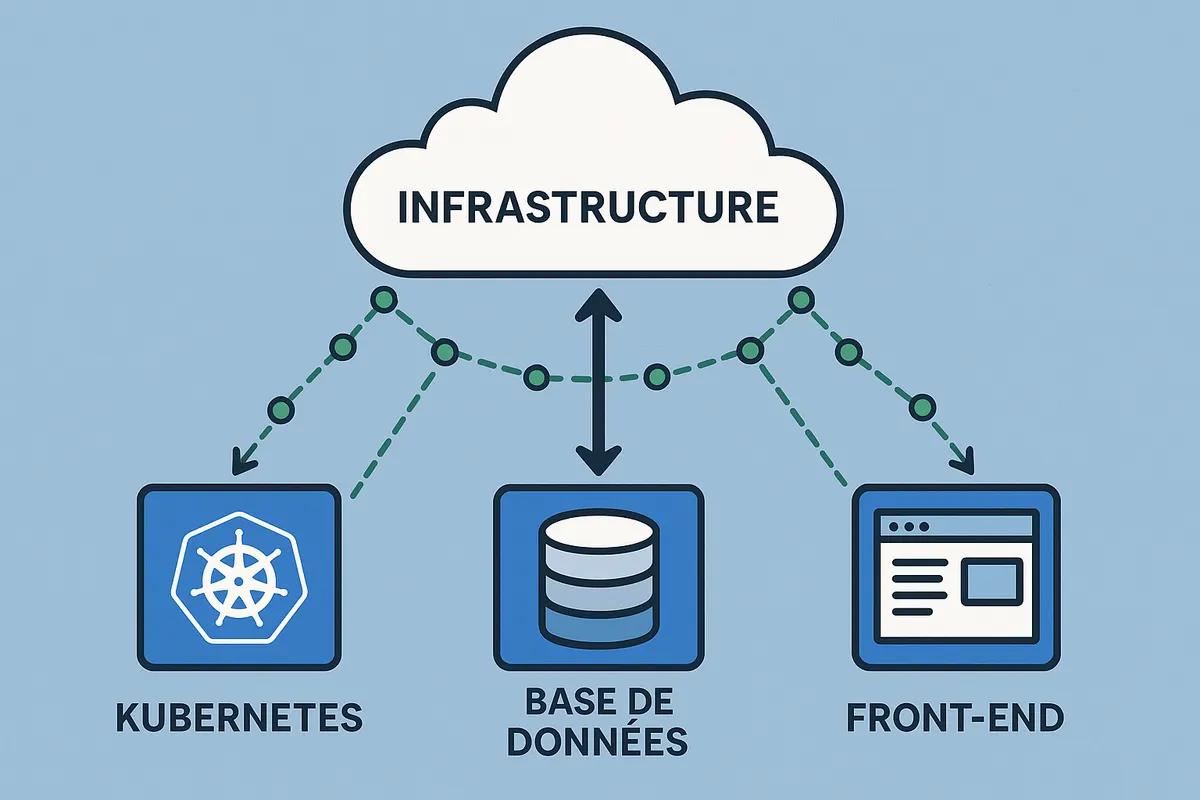
- Déclarer les probes dès la configuration Kubernetes : liveness et readiness probes permettent au scheduler de redémarrer automatiquement les pods défaillants sans intervention humaine.
- Standardiser les logs au format JSON : adoptez des champs communs (
level,service,trace_id) dans tous les services pour faciliter les corrélations multi-sources. - Maintenir la parité staging/production : un dashboard qui ne reflète que la production crée un angle mort. La parité des environnements est une condition de fiabilité des alertes et de réactivité lors des déploiements.
- Corréler métriques et traces lors des pics de charge : pendant un Black Friday ou une campagne emailing, cette corrélation permet d'isoler le service responsable d'une dégradation en quelques minutes plutôt qu'en quelques heures.
Avant d'investir dans une refonte de votre observabilité, un audit technique de votre infrastructure e-commerce permet d'identifier les composants non instrumentés et les dettes opérationnelles accumulées.
Alertes calibrées et réponse aux incidents
Un monitoring qui génère trop d'alertes devient contre-productif : l'équipe finit par les ignorer. Quelques principes pour calibrer correctement vos seuils :
- Alerter sur les symptômes, pas les causes : une alerte sur « taux d'erreur 5xx sur le paiement supérieur au seuil » est actionnelle. Une alerte sur « CPU élevé » est souvent du bruit sans contexte fonctionnel.
- Définir des SLO (Service Level Objectives) : exprimez vos objectifs de disponibilité et de performance en termes d'expérience utilisateur. Cela aligne l'équipe technique sur l'impact business plutôt que sur des métriques système abstraites.
- Documenter les runbooks : pour chaque alerte critique, un runbook décrit les étapes de diagnostic et la procédure de rollback, accessible à toute l'équipe sans expertise système approfondie.
Votre pipeline de qualité gagne à compléter le monitoring par des tests automatisés pour la QA e-commerce, qui détectent les régressions fonctionnelles avant qu'elles n'alimentent vos tableaux d'alerte.
Supervision continue : déléguer ou internaliser ?
Mettre en place un monitoring robuste mobilise du temps de configuration et une culture opérationnelle que toutes les équipes produit n'ont pas en interne. Si votre équipe est principalement orientée développement, déléguer la supervision de l'infrastructure à une équipe spécialisée présente un avantage concret : réponse aux incidents sans affecter votre capacité de livraison, regard externe sur vos angles morts, et SLO contractuels mesurés.
Sentinelo, la solution de supervision e-commerce de Webntricks, assure le monitoring continu de votre infrastructure avec un RTO contractuel inférieur à une heure. Elle s'intègre à votre stack existante sans refonte de votre code applicatif.
Pour un accompagnement plus large sur l'architecture et la performance de votre plateforme, découvrez nos expertises techniques.
Questions fréquentes
C'est quoi le monitoring en DevOps ?
Le monitoring DevOps désigne l'ensemble des pratiques permettant de suivre en continu la santé des applications et des infrastructures. Il couvre la collecte de métriques, la centralisation des logs et les traces distribuées, afin d'anticiper les incidents et d'améliorer la performance de façon mesurable.
Quelle est la différence entre monitoring et observabilité ?
Le monitoring mesure des indicateurs connus à l'avance (disponibilité, latence, taux d'erreur) et déclenche des alertes sur seuil. L'observabilité va plus loin : elle permet d'inférer l'état interne d'un système à partir de ses sorties — métriques, logs et traces distribuées — y compris pour des événements imprévus non anticipés lors de la conception.
Comment choisir les bons outils de monitoring pour mon e-commerce ?
Partez de votre architecture : Kubernetes et conteneurs orientent vers Prometheus et Grafana. Si votre équipe préfère une solution managée, Datadog ou New Relic réduisent la charge opérationnelle. Définissez d'abord les métriques critiques pour votre activité (tunnel de commande, API de paiement, jobs asynchrones) avant de choisir l'outillage.